SNS 공유 미리보기
API 재시도와 멱등성 - 주문과 작업이 두 번 처리되지 않게 설계하기
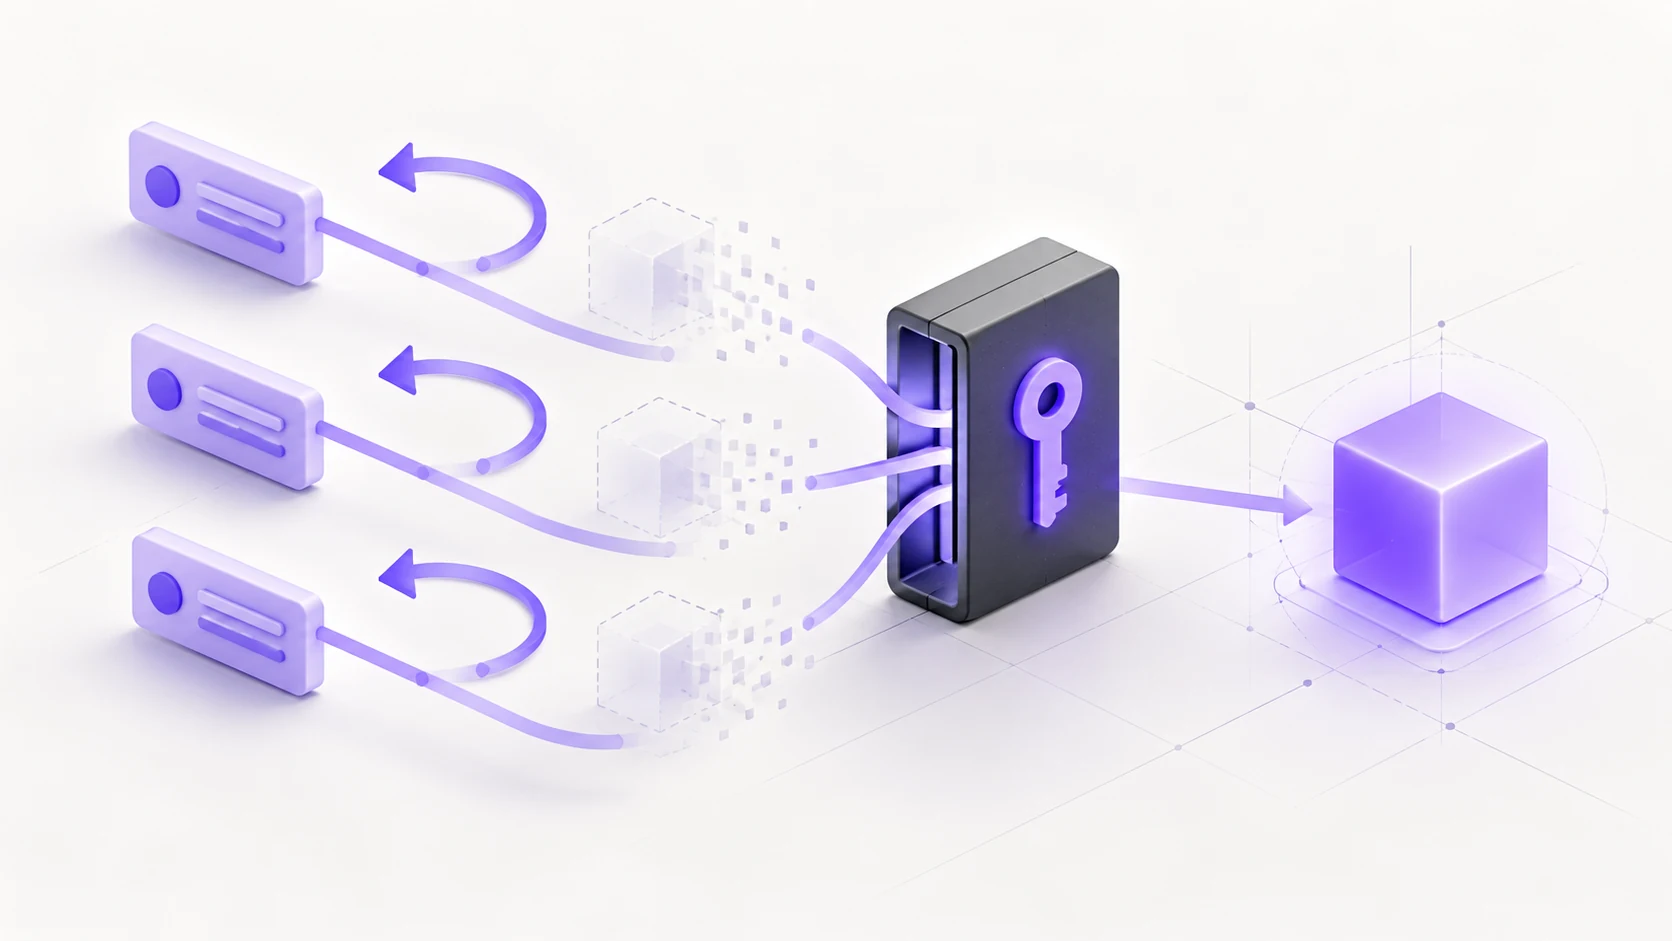
시간 초과 뒤 재시도가 주문이나 작업을 중복 생성하는 이유를 설명하고, 동일 작업의 키 유지, DB 유일성 제약과 트랜잭션, 아웃박스와 외부 결과 대조, 백오프·지터·시간 제한, 키 보관 기간과 실패 주입 테스트까지 단계별로 정리한다.
카카오톡, 페이스북 등 SNS 공유 시
위와 같은 형태로 노출됩니다.
API 재시도와 멱등성 - 주문과 작업이 두 번 처리되지 않게 설계하기
요청은 실패한 것 같은데, 주문은 이미 만들어졌다면 어떻게 해야 할까요?
주문 버튼을 눌렀는데 로딩 표시만 계속 돌아요. 잠시 뒤 화면에 시간 초과가 뜹니다. 사용자는 다시 눌러도 되는지 모르겠고, 개발자는 일단 재시도하면 해결될 것 같아요. 그런데 첫 요청이 서버까지 도착해서 이미 처리됐다면 이야기가 달라집니다. 응답만 돌아오지 않은 상태에서 주문이나 작업이 한 번 더 만들어질 수 있어요.
이 문제는 결제에서만 생기지 않습니다. 보고서 생성, PDF 변환, 메일 발송, 외부 API 호출처럼 결과가 남는 기능이라면 모두 살펴볼 만해요. 버튼을 잠시 비활성화하는 것도 도움이 되지만, 새로고침이나 모바일 네트워크 단절, 서버끼리의 재전송까지 막아 주지는 못합니다.
그래서 재시도 로직을 넣기 전에 먼저 정할 것이 있어요. 어떤 요청들을 같은 작업으로 볼지, 이미 처리한 작업의 결과를 어떻게 다시 확인할지입니다. 이번 글에서는 이 기준을 멱등성 키, 데이터베이스 트랜잭션, 비동기 작업, 재시도 제한까지 연결해서 정리해 볼게요.
STEP 01멱등성은 의도한 결과가 반복해서 늘어나지 않는 성질이에요
멱등성이라는 단어가 조금 어렵게 느껴질 수 있어요. API에서는 같은 요청을 여러 번 처리했을 때, 서버에 의도한 효과가 한 번 처리한 경우와 같다는 뜻입니다. HTTP 표준은 PUT, DELETE와 안전한 메서드들을 멱등한 메서드로 정의해요. 다만 실제 서버 구현이 그 의미를 지켜야 합니다. 메서드 이름만 PUT으로 바꾼다고 중복 방지가 완성되는 것은 아니에요. RFC 9110의 멱등성 정의에서 확인할 수 있습니다.
예를 들어 특정 작업을 삭제한 뒤 같은 삭제 요청을 다시 보내면, 두 번째에는 이미 없다는 응답이 올 수 있어요. 응답 코드가 달라도 ‘그 작업이 없는 상태’라는 의도한 효과는 같습니다. 반대로 POST로 새 작업을 만드는 API는 호출할 때마다 새 행을 추가할 수 있어요. POST와 PATCH는 메서드 자체만으로 멱등성을 보장하지 않으므로 API 계약을 따로 확인해야 합니다. MDN의 사례 설명도 응답의 동일함과 효과의 동일함을 구분해요.
현재 화면에서 연속 클릭을 줄여요. 다른 탭, 새로고침, 서버 재전송은 별도 대응이 필요해요.
같은 논리적 작업을 식별해요. 재요청이 와도 새 작업을 만들지 않도록 서버가 처리해요.
저장해 둔 결과를 빨리 돌려줘요. 캐시가 사라져도 중복 처리가 안전한지는 따로 확인해야 해요.
겹친 실행이나 충돌하는 변경을 조정해요. 같은 작업인지 판단하는 기준도 함께 있어야 해요.
설계 비교 도식입니다. 화면 제어, 멱등성, 캐시, 잠금은 서로를 자동으로 대체하지 않습니다.
또 하나 구분할 것이 있습니다. 요청 로그가 두 줄 남는 것과 주문이 두 개 만들어지는 것은 다른 문제예요. 재요청을 관찰하기 위한 로그는 매번 남아도 됩니다. 우리가 보호하려는 것은 주문 생성, 잔액 변경, 파일 발송처럼 업무상 한 번만 발생해야 하는 효과예요.
STEP 02키는 전송 횟수보다 사용자의 작업 의도를 따라가요
가장 중요한 규칙은 간단합니다. 같은 작업을 다시 보내는 동안에는 같은 키를 사용하고, 사용자가 별개의 새 작업을 시작할 때 새 키를 만들어요. 재시도 함수 안에서 매번 UUID를 생성하면 서버에는 전부 다른 작업으로 보입니다. 키가 있어도 중복 방지는 작동하지 않아요.
가상의 보고서 생성 화면을 생각해 볼게요. 사용자가 대상 기간과 보고서 종류를 정하고 ‘생성’을 누르는 순간 하나의 명령을 만듭니다. 이 명령에 키를 붙이고, 서버가 작업 접수를 확인할 때까지 명령 내용과 키의 연결을 유지해요. 연결이 끊기면 동일한 명령을 동일한 키로 다시 보냅니다. 응답을 받았거나 상태 조회로 접수 사실을 확인하면 해당 작업 번호를 보여 주면 됩니다.
같은 기간의 보고서를 의도적으로 두 번 만드는 경우도 있을 수 있어요. 이때 입력 내용만 해시해서 키로 쓰면 서로 다른 요청이 하나로 합쳐집니다. 입력값은 ‘내용이 같은지’ 판단하는 자료이고, 키는 ‘같은 작업을 다시 보내는지’ 나타내는 식별자로 나누는 편이 이해하기 쉬워요. AWS도 호출자가 제공한 요청 식별자를 통해 의도를 구분하는 설계를 설명합니다. AWS Builders’ Library의 설계 설명을 참고하세요.
서버에서는 키 문자열 하나만으로 모든 사용자를 묶지 않도록 합니다. 이 글의 예시에서는 인증된 계정, 작업 종류와 버전, 멱등성 키의 조합을 식별 범위로 사용해요. 계정은 요청 본문을 그대로 믿지 말고 인증 결과에서 가져옵니다. 다른 사용자가 같은 키를 보내더라도 다른 사람의 결과가 돌아가서는 안 되기 때문이에요.
추적용 request ID와 멱등성 키도 목적이 달라요. request ID는 각 전송을 구분하므로 시도마다 달라질 수 있습니다. 멱등성 키는 재시도 사이에 유지돼야 합니다. 로그에는 두 식별자의 연결 관계를 남기되, 키를 비밀번호처럼 다루거나 이메일 주소를 키로 만드는 방식은 피하는 편이 좋습니다.
사용자가 응답을 기다리다가 옵션을 수정한 경우도 정해야 해요. 앞선 작업이 접수됐는지 모르는 상태에서 키만 새로 만들어 다시 제출하면 두 작업이 생길 수 있습니다. 먼저 기존 작업을 조회하고, 취소가 필요한지 또는 새 작업을 추가할지 화면에서 구분해 주세요. ‘다시 시도’와 ‘새로 생성’의 의미가 UI와 API에서 일치해야 합니다.
STEP 03같은 DB 안에서 끝나는 작업은 한 트랜잭션으로 묶어요
키가 이미 있는지 조회하고, 없으면 처리하는 코드는 보기에는 자연스럽습니다. 하지만 요청 두 개가 거의 동시에 들어오면 둘 다 ‘없음’을 확인할 수 있어요. 그 뒤 각각 작업을 만들면 중복입니다. 애플리케이션의 사전 조회만으로 끝내지 말고 데이터베이스에 유일성 제약을 두어야 해요.
PostgreSQL에서는 여러 열의 조합에도 UNIQUE 제약을 설정할 수 있습니다. 아래는 그 기능을 이용한 예시 구조예요. 기본 동작에서는 NULL의 중복 취급이 별도로 적용되므로, 식별에 필요한 열은 NOT NULL로 명시합니다. PostgreSQL 공식 제약 조건 문서에서 유일성과 NULL 처리 규칙을 확인할 수 있어요.
-- 개념을 설명하는 예시 스키마입니다.
CREATE TABLE api_commands (
  account_id   uuid        NOT NULL,
  operation    text        NOT NULL,
  request_key  text        NOT NULL,
  payload_hash text        NOT NULL,
  result_id    uuid,
  created_at   timestamptz NOT NULL DEFAULT now(),
  UNIQUE (account_id, operation, request_key)
);
짧은 내부 작업이라면 다음 순서로 설계할 수 있습니다. 먼저 인증과 입력 검증을 끝냅니다. 그다음 트랜잭션을 열고 명령 행을 삽입해 처리 권한을 확보해요. 새 명령이면 실제 업무 데이터를 변경하고 결과 식별자를 기록한 뒤 함께 커밋합니다. 중간에 실패하면 명령과 업무 변경이 같이 롤백되도록 합니다.
하나의 DB 트랜잭션 안에서
계정 + 작업 종류 + 키의 유일성 제약으로 동시 중복을 판별
주문 또는 작업 행 생성. 이 단계에 원격 API 호출은 넣지 않음
결과 ID를 명령에 연결하고 모든 DB 변경을 함께 확정
예시 설계입니다. 경합 시 대기·재조회 방식은 DB 격리 수준과 사용 중인 드라이버에 맞게 구현해야 합니다.
이미 처리된 키가 들어오면 입력 내용도 비교해요. 같은 키로 수량이나 대상 기간이 달라졌다면 조용히 이전 결과를 돌려주기보다 오류로 알려야 합니다. 해시를 사용할 때는 JSON 속성 순서, 생략된 기본값, 날짜 표현처럼 의미는 같은데 문자열이 달라지는 경우를 정규화해야 해요. 작업에 영향을 주는 필드가 비교 대상에서 빠지지 않는지도 확인합니다.
유일성 충돌을 잡은 뒤 같은 트랜잭션에서 곧바로 조회하면 항상 된다고 생각하지 않는 것이 좋습니다. DB와 오류 처리 방식에 따라 트랜잭션 자체가 실패 상태일 수 있어요. PostgreSQL에서는 ON CONFLICT 같은 충돌 처리 방법이나 적절한 롤백·재조회 경로를 선택하고, 경쟁 요청이 커밋되는 경우와 롤백되는 경우를 모두 테스트해야 합니다. 여기서는 구체적인 SQL 구현보다 보장해야 할 경계를 먼저 잡는 것이 목적이에요.
캐시 서버의 짧은 잠금만으로 모든 것을 해결하려는 경우도 살펴봐야 합니다. 잠금이 만료된 뒤 첫 번째 작업이 계속 실행되면 두 번째 작업이 시작될 수 있어요. 재시작이나 데이터 유실에도 남아야 하는 중복 방지 기록이라면 업무 데이터와 함께 관리할 저장소를 정하는 편이 안전합니다. 잠금의 수명과 작업의 수명이 같을 것이라고 가정하지 마세요.
STEP 04외부 호출이 끼면 완료 여부를 모르는 구간을 따로 다뤄요
앞의 방식은 같은 데이터베이스 안에서 끝나는 변경에 잘 맞아요. 그런데 주문을 저장하면서 외부 메일 서비스를 호출하면 어떻게 될까요? 메일은 발송됐지만 DB 커밋은 실패할 수 있습니다. 반대로 DB는 커밋됐지만 발송 전에 프로세스가 꺼질 수도 있어요. 외부 HTTP 호출까지 로컬 DB 트랜잭션이 되돌려 주지는 않습니다.
이때 사용할 수 있는 구조가 트랜잭셔널 아웃박스예요. 업무 데이터와 ‘나중에 전달해야 할 이벤트’를 같은 트랜잭션에 기록한 뒤, 별도의 전달 작업이 이벤트를 보냅니다. DB 저장과 전송 사이의 누락 위험을 관리할 수 있지만, 전달자가 전송 직후 죽으면 같은 이벤트를 다시 보낼 수 있어요. 받는 쪽에서도 이벤트 식별자를 기준으로 중복을 다루어야 합니다. AWS의 transactional outbox 설명도 중복 전달과 멱등 소비자 처리를 함께 다룹니다.
명령 키, 작업 행, 아웃박스 이벤트를 함께 저장해요. 기존 키에는 같은 작업 ID를 반환해요.
전달이 반복될 수 있다고 가정해요. 소비자는 이벤트 ID와 업무 상태로 중복을 판별해요.
사용자는 작업 ID로 진행 상태를 확인해요. 응답이 늦었다고 새 작업을 만들지 않아요.
일반적인 아웃박스 구조를 바탕으로 한 작업 처리 예시입니다. 이 도식만으로 모든 외부 효과의 정확히 한 번 실행이 보장되지는 않습니다.
오래 걸리는 PDF 변환이나 보고서 작성이라면 접수 API가 작업 ID와 조회 주소를 반환하는 형태가 이해하기 쉬워요. 예를 들어 접수 응답은 202로 처리하고, 조회 화면에서는 대기, 실행 중, 완료, 실패를 보여 줄 수 있습니다. 구체적인 응답 코드는 API 계약에 맞춰 정하되, 동일 접수 키가 작업 두 개로 이어지지 않도록 해야 합니다.
워커에도 주의할 부분이 있어요. 실행 중인 작업을 일정 시간이 지났다는 이유만으로 곧바로 다시 실행하면, 원래 워커가 살아 있는 경우 중복됩니다. 실행 소유권, 갱신 시각, 조건부 상태 변경, 재실행 권한을 함께 설계해야 합니다. 워커가 결과를 저장하는 순간에도 자신이 여전히 유효한 실행자인지 확인할 수 있어야 해요.
외부 제공자가 멱등성 키를 지원한다면 내부 명령에 연결된 외부 요청 키를 보관하고 재시도 때 재사용합니다. 지원하지 않는 서비스라면 외부 결과를 조회하거나 정합성을 대조하는 절차가 필요할 수 있어요. 특히 돈이나 발송처럼 되돌리기 어려운 효과는 ‘실패’와 ‘완료 여부 미확인’을 구분하고, 미확인 상태를 무조건 새 요청으로 해결하지 않는 것이 중요합니다.
STEP 05재시도는 대상 오류와 횟수와 총시간을 함께 정해요
멱등성 처리를 넣었다면 이제 재시도 정책을 정할 차례입니다. 모든 오류를 같은 간격으로 반복해서 보내면 장애 중인 서버에 요청만 더 쌓일 수 있어요. AWS의 신뢰성 지침은 지수 백오프, 지터, 최대 재시도 횟수를 함께 다루고, 여러 계층의 중복 재시도를 경계합니다. Control and limit retry calls를 기준으로 실제 의존 서비스의 오류 정의를 확인해 주세요.
- 연결 단절·시간 초과
- 서버에서 처리됐는지 알 수 없을 수 있어요. 멱등성 계약을 확인하고 같은 키로 재요청하거나 작업 상태를 조회해요.
- 400·401·403 등
- 입력, 인증, 권한 문제를 먼저 확인해요. 동일한 잘못된 요청을 자동으로 반복하지 않아요.
- 429·일시적 5xx
- 제공자의 재시도 가능 오류 목록을 확인해요. 허용된 경우 대기 시간, 횟수, 전체 시간 제한을 적용해요.
- 409·진행 중 응답
- 코드 하나로 결정하지 않아요. 키 충돌인지 업무 충돌인지 구분하고, 계약에 따라 조회하거나 입력을 수정해요.
- 결과 미확인
- 새 키를 발급하기 전에 기존 작업을 대조해요. 안전한 자동 복구 근거가 없으면 확인이 필요한 상태로 남겨요.
일반적인 검토 기준입니다. 특정 상태 코드가 모든 API에서 항상 재시도 가능하거나 불가능하다는 뜻은 아닙니다.
백오프는 실패가 이어질수록 대기 간격을 늘리는 방식이고, 지터는 각 요청이 똑같은 순간에 몰리지 않도록 대기 시간에 무작위성을 넣는 방식입니다. 간단한 설계 예시로는 재시도 차수에 따라 증가하는 상한 안에서 대기 시간을 뽑을 수 있어요. 다만 사용자 화면에서 몇 초를 기다릴지와 백그라운드 작업을 얼마나 오래 복구할지는 별개의 정책으로 정하는 편이 좋습니다.
횟수만 제한하면 한 번의 호출이 아주 오래 걸리는 문제를 놓칠 수 있어요. 각 호출의 제한 시간과 전체 작업의 시간 예산을 같이 확인합니다. 연결 수립, 응답 대기, 재시도 간 대기까지 포함했을 때 사용자가 감당할 수 있는 시간인지 보는 거예요. 총시간을 넘기면 무작정 다음 호출을 시작하지 말고 상태 조회나 나중에 확인하는 흐름으로 넘깁니다.
서버가 Retry-After를 내려주면 그 의미도 반영해야 합니다. 이 값은 기다릴 초 단위 숫자일 수도 있고 HTTP 날짜일 수도 있어요. 서버가 요청한 대기 시간이 남은 시간 예산보다 길다면, 기다릴 시간을 임의로 줄여 재호출하기보다 현재 자동 재시도를 끝내고 사용자에게 안내하는 정책을 선택할 수 있습니다. 헤더 형식은 MDN Retry-After 문서를 참고하세요.
SDK에 이미 재시도가 있는지도 꼭 확인합니다. 예를 들어 바깥 코드가 총 세 번 시도하고, 안쪽 SDK도 매번 총 세 번 시도하면 실제 외부 호출은 최대 아홉 번이 될 수 있어요. 이 숫자는 계층 중첩을 보여 주는 계산 예시입니다. 재시도 책임을 한 계층에 모으고 다른 계층의 기본값을 확인하면 동작을 예측하기 쉬워집니다.
화면을 닫거나 브라우저 요청을 취소했다고 서버의 작업도 취소되는 것은 아니에요. 사용자에게 ‘요청 대기를 멈춤’과 ‘작업 취소 완료’를 구분해서 보여 주세요. 서버 작업 취소는 별도의 상태 변경과 경쟁 조건을 가진 기능으로 다뤄야 합니다.
STEP 06키를 언제 지울지와 모호한 결과를 어떻게 복구할지 정해요
멱등성 기록을 영원히 보관하기는 어렵습니다. 그렇다고 짧게 지우면 늦게 도착한 재요청이 새로운 작업으로 처리될 수 있어요. 키 보관 기간은 저장 비용만 보고 정하기보다, 클라이언트의 최대 재시도 기간과 오프라인 복귀 시간, 큐 재전달과 운영자 재처리 시간을 함께 검토해야 합니다.
Stripe의 동작은 구체적인 계약의 좋은 사례예요. 공식 문서는 실행이 시작된 요청의 상태 코드와 본문을 저장하고, 같은 키에는 500 응답도 다시 반환할 수 있다고 설명합니다. 키는 최소 24시간이 지난 뒤 제거될 수 있고, 제거된 키를 다시 사용하면 새 요청이 됩니다. 입력 검증 실패나 실행 중 요청과의 충돌은 결과 저장 조건이 다르므로 문서를 구분해서 읽어야 해요. Stripe Idempotent requests에 나온 이 규칙을 모든 서비스의 공통 규칙으로 적용하면 안 됩니다.
여기서 중요한 실무 판단은 ‘같은 키로 500이 계속 온다’는 이유만으로 새 키를 만들어 우회하지 않는 것입니다. 기존 시도의 효과가 있었는지 먼저 확인해야 해요. 자동으로 확인할 수 없는 경우에는 요청 식별자와 외부 거래·작업 식별자를 남겨 운영자가 대조할 수 있도록 합니다. 미확인 건이 조용히 실패 목록에 섞이면 나중에 중복 처리의 원인을 찾기 어려워집니다.
주문 번호나 접수 번호처럼 업무상 유일한 식별자가 있다면 추가 방어선으로 활용할 수 있어요. 멱등성 응답 기록의 보관 기간이 끝나더라도 동일 업무 식별자에 대한 중복 생성 제한은 유지하는 설계입니다. 다만 보고서를 의도적으로 다시 만드는 기능처럼 반복이 정당한 업무도 있으니, 어떤 식별자가 정말 유일해야 하는지는 먼저 정의해야 합니다.
저장된 응답을 재사용할 때도 현재 요청자의 권한 확인은 생략하지 마세요. 멱등성 키는 권한 증명이 아닙니다. 응답 본문에 민감한 정보를 통째로 보관할 필요가 있는지도 검토하고, 가능하면 결과 식별자와 복구에 필요한 최소한의 정보를 저장합니다. 로그 역시 원문 입력을 무조건 남기는 것보다 키, 작업 ID, 시도 횟수, 결과 상태를 중심으로 구성하는 편이 관리하기 좋아요.
STEP 07정상 요청보다 실패하는 순간을 먼저 테스트해요
단위 테스트에서 같은 함수를 두 번 호출해 보는 것만으로는 부족합니다. 실제로 문제가 생기는 구간은 DB 커밋 직후, 응답 전송 직전, 외부 호출 직후처럼 경계에 있어요. 테스트 환경에서 이 구간을 의도적으로 끊고 최종 업무 데이터와 외부 호출 기록을 함께 확인해 보세요.
- 응답만 유실시키기. 업무 데이터는 커밋된 상태로 두고 클라이언트가 시간 초과를 받게 합니다. 같은 키로 재요청했을 때 새 행 대신 기존 결과가 돌아오는지 확인해요.
- 동일 키를 동시에 보내기. 순차 두 번이 아니라 경쟁하는 요청을 만듭니다. 최종 작업 수가 하나인지, 다른 요청은 문서화된 응답을 받는지 확인해요.
- 같은 키에 다른 입력 보내기. 수량이나 대상 기간을 바꿉니다. 이전 결과를 무심코 반환하거나 두 번째 작업을 만들지 않고 충돌을 알리는지 확인해요.
- 트랜잭션 중간에 실패시키기. 명령 기록만 남거나 업무 변경만 남지 않는지 봅니다. 롤백 이후의 동일 키 요청도 정상 경로로 복구되는지 확인해요.
- 외부 호출 직후 워커 종료하기. 외부 결과는 생겼지만 내부 완료 표시가 없는 경우를 만듭니다. 외부 멱등성 또는 결과 대조 절차가 작동하는지 확인해요.
- 계정과 보관 기간 경계 확인하기. 다른 계정의 같은 키, 만료 직전 재요청, 만료 후 재요청을 구분해 테스트합니다. 결과 유출과 조용한 중복 생성을 함께 확인해요.
운영 지표도 성공률 하나만으로 끝내지 않는 것이 좋아요. 전체 요청 중 재사용된 키의 비율, 같은 키에 입력이 달랐던 건수, 진행 중 상태가 오래 유지된 작업 수, 외부 결과 미확인 건수를 따로 보면 장애가 생긴 지점을 좁히기 쉽습니다. 이 지표들은 서비스에 맞게 고르는 설계 제안이며, 일정한 수치가 모든 시스템의 정상 기준이 되지는 않습니다.
중복 방지율이 높아졌다고 무조건 잘되고 있다고 판단할 수도 없어요. 프런트엔드가 의도치 않게 같은 요청을 계속 보내는 경우에도 그 수치는 올라갑니다. 재시도 횟수와 응답 지연을 같이 보고, 실제 사용자 작업 수와 API 요청 수의 차이가 왜 늘어났는지 확인해야 합니다.
STEP 08기존 서비스에는 결과가 크게 남는 API부터 적용해 보세요
모든 API를 한 번에 바꾸기보다, 중복됐을 때 비용이 큰 생성 API 하나를 먼저 고르는 편이 현실적입니다. 주문 생성, 유료 작업 접수, 외부 발송 중 하나를 선택하고 요청부터 결과 확인까지의 경로를 그려 보세요. 각 구간에서 프로세스가 멈추면 어떤 흔적이 남는지 적으면 필요한 보장 범위가 보입니다.
그다음 API 계약에 키의 생성 주체, 유지 범위, 다른 입력의 처리, 진행 중 응답, 보관 기간, 결과 조회 방법을 적습니다. 서버부터 키를 인식하게 준비한 뒤 클라이언트가 키를 보내도록 순서를 잡고, 전환 기간에 키가 없는 요청을 어떻게 처리할지도 정해 주세요. 적용 도중부터 무조건 재시도를 켜면 이전 경로에서 중복이 생길 수 있습니다.
마지막으로 운영자가 미확인 작업을 발견했을 때 따라갈 짧은 절차를 남겨 두면 좋습니다. 내부 작업 ID로 조회하고, 외부 작업 ID로 결과를 대조하고, 확인된 경우에만 상태를 보정하는 식이에요. ‘다시 실행’ 버튼이 있다면 새 작업을 만드는 버튼인지, 동일 작업을 안전하게 복구하는 버튼인지 명확해야 합니다.
재시도가 안전하려면 같은 작업을 알아보는 키가 필요하고, 그 키와 실제 업무 결과가 함께 남아야 해요. 여기에 외부 효과를 확인할 경로와 재시도의 종료 조건까지 있어야 장애 중에도 동작을 설명할 수 있습니다. 우선 API 하나에서 응답 유실 테스트부터 해 보세요. 정상 화면에서는 보이지 않던 중복 처리 구간을 찾는 데 도움이 됩니다.
REFERENCES
- 원문 보기
RFC 9110 · HTTP Semantics 9.2.2 Idempotent Methods
멱등성의 정의와 비멱등 요청 자동 재시도의 조건.
- 원문 보기
MDN · Idempotent
메서드별 의미와 응답이 달라도 멱등할 수 있는 사례.
- 원문 보기
AWS Builders’ Library · Making retries safe with idempotent APIs
호출자 요청 식별자, 원자적 기록, 늦은 재요청과 다른 입력.
- 원문 보기
PostgreSQL · Unique Constraints
복합 유일성 제약과 NULL 처리.
- 원문 보기
AWS Prescriptive Guidance · Transactional outbox pattern
업무 변경과 이벤트의 동시 저장, 중복 전달 고려.
- 원문 보기
AWS Well-Architected · Control and limit retry calls
백오프, 지터, 최대 횟수·시간과 중첩 재시도 관리.
- 원문 보기
MDN · Retry-After header
초 단위 대기 시간과 HTTP 날짜 형식.
- 원문 보기
Stripe API · Idempotent requests
Stripe의 결과 재사용, 보관 기간, 입력 비교와 저장 예외.